Para Jean Pierre Lessa e Santos Ferreira, especialista em tecnologia, software e inteligência artificial, uma infraestrutura resiliente não é a que promete nunca falhar. É a que limita o alcance de uma falha, mantém os serviços prioritários e recupera a operação com decisões previamente testadas.
Essa diferença separa disponibilidade de resiliência. A primeira busca manter o serviço ativo; a segunda prepara a organização para operar durante uma degradação e retornar ao funcionamento normal depois de um evento adverso.
Comparar essas duas dimensões ajuda a evitar investimentos desequilibrados. Uma empresa pode comprar redundância e continuar sem backup validado, ou criar um plano de recuperação que não considere as dependências reais das aplicações.
Prevenir ou recuperar: qual é a prioridade?
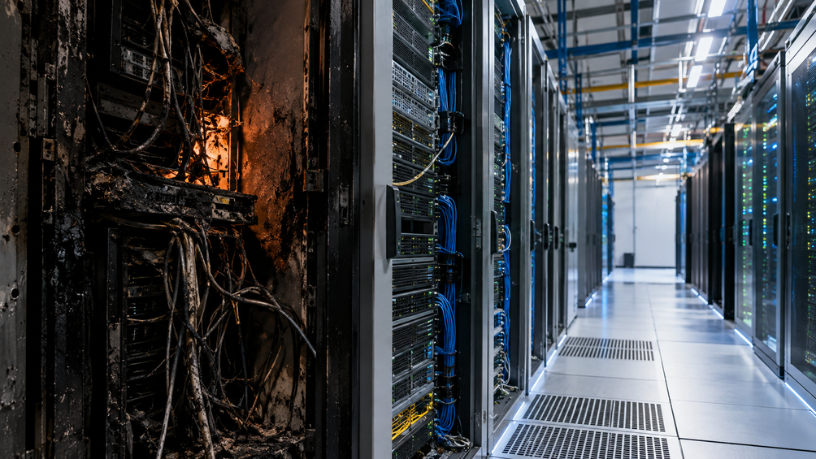
A prevenção atua antes do incidente, com redundância de energia, refrigeração, conectividade, sistemas e equipes. Seu objetivo é impedir que uma falha isolada interrompa o serviço. Quando bem desenhada, ela reduz a frequência de eventos que chegam ao usuário.
A recuperação começa quando a prevenção não foi suficiente. Ela depende de cópias utilizáveis, ambientes alternativos, procedimentos de restauração e critérios claros para decidir entre reparar, transferir ou reduzir o serviço. Não é uma etapa inferior, mas uma camada diferente de proteção.
A prioridade deve ser definida pelo impacto do negócio. O NIST recomenda avaliar sistemas e operações para determinar requisitos e prioridades de contingência. Assim, a organização consegue concentrar recursos nos serviços cuja interrupção produz consequências mais graves.
Redundância ou simplicidade operacional?
A redundância cria alternativas, mas também aumenta a quantidade de componentes e decisões que precisam ser administrados. Dois caminhos de rede, por exemplo, não oferecem proteção suficiente se o monitoramento não mostra a falha ou se a equipe não sabe qual rota ativar.
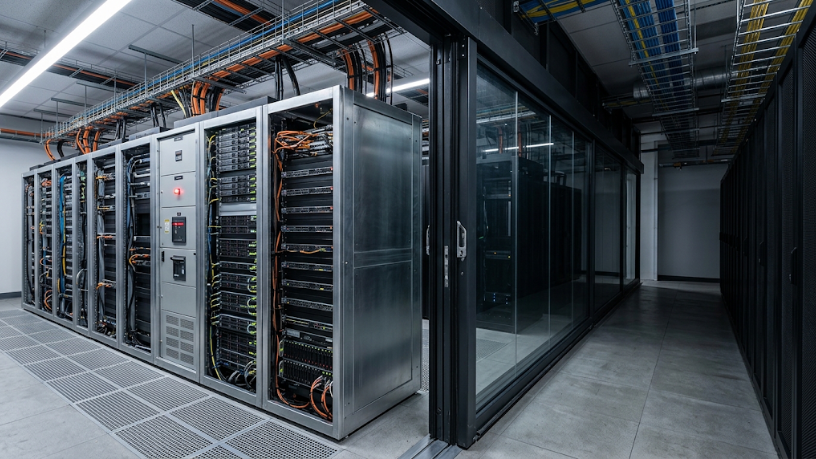
Jean Pierre Lessa e Santos Ferreira destaca que a arquitetura mais resiliente é a que pode ser operada sob pressão. Procedimentos simples, responsabilidades definidas e sinais objetivos de mudança reduzem o tempo gasto para interpretar o problema durante um incidente.
Isso não significa escolher a solução mais básica. Significa avaliar o custo operacional da complexidade. Uma topologia sofisticada, mas mal documentada, pode reagir pior do que uma estrutura menos abrangente, porém conhecida e testada pelas equipes responsáveis.
Backup ou replicação: qual protege melhor?
Backup e replicação cumprem funções diferentes. A replicação mantém uma cópia próxima e atualizada, útil para reduzir o tempo de retomada. O backup preserva estados anteriores, importantes quando os dados replicados também carregam corrupção, exclusões indevidas ou alterações maliciosas.
A escolha depende do objetivo de recuperação. O RPO define quanta informação pode ser perdida; o RTO indica quanto tempo o serviço pode levar para voltar. Jean Pierre Lessa e Santos Ferreira considera esses parâmetros necessários para saber se a estratégia atende ao negócio.
O teste de restauração é o ponto decisivo. Um arquivo armazenado não prova que a aplicação será recuperada. É preciso verificar permissões, consistência, dependências, capacidade do ambiente e comportamento do serviço depois da restauração.
Plano documentado ou capacidade demonstrada?
Um documento de continuidade descreve intenções; um exercício demonstra capacidade. Simulações de perda de enlace, falha de energia, indisponibilidade de um site ou corrupção de dados revelam tempos reais, lacunas de comunicação e passos que não funcionam como previsto.
O exercício deve produzir evidências. Registre o que foi acionado, quanto tempo cada etapa levou, quais decisões ficaram pendentes e quais dados não estavam disponíveis. Depois, transforme as falhas encontradas em ajustes de arquitetura, treinamento ou procedimento. A resiliência se constrói pela repetição desse ciclo.
Essa visão muda a pergunta central da infraestrutura. Em vez de perguntar apenas se o datacenter tem componentes suficientes, é preciso saber se a operação reconhece uma falha, mantém o que é prioritário e recupera o restante com segurança. Jean Pierre Lessa e Santos Ferreira conclui que é essa capacidade comprovada que transforma redundância em resiliência.